Русский ИТ бизнес
Русский ИТ бизнес

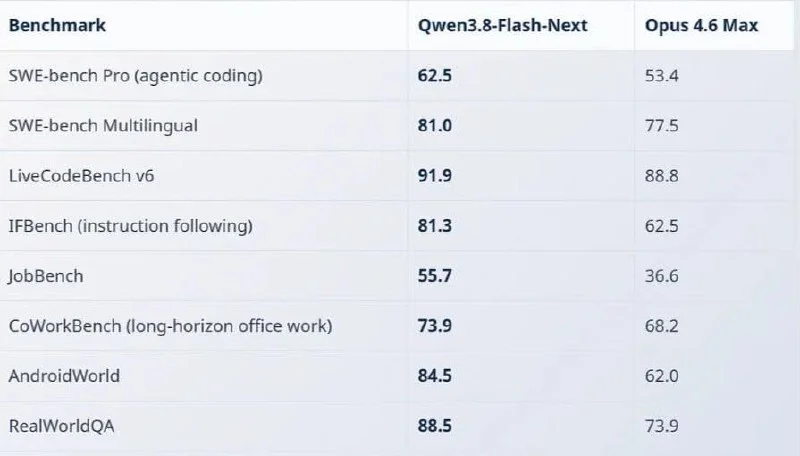
⚡️ Полную 125B-модель Qwen запустили на RTX 4090 с всего 6 ГБ VRAM

⚡️ Полную 125B-модель Qwen запустили на RTX 4090 с всего 6 ГБ VRAM
⚡️ Полную 125B-модель Qwen запустили на RTX 4090 с всего 6 ГБ VRAM.

Обычно такой checkpoint весит 360 ГБ и требует серверов. Но инженеры сделали это на домашней 4090 без квантизации — пик 5,95 ГБ. Модель полная, с vision и 262K контекстом.

VRAM больше не главная проблема для игровых моделей. Но я скажу свое мнение - мы наигрались в локальные модели, хватит... Карты продали.

tg / max
Комментарии (35)

  • Импульсивный Охотник
    Импульсивный Охотник
    продавай хату и переходи на съем. продавай машину и переходи на каршер.. и так далее. Ответить
  • Мудрый Маркиз
    Мудрый Маркиз
    Я думаю будущее за локальной моделью, можешь делать что хочешь без ограничений Ответить
    раскрыть ветку (24)
    • Кожаный Карьерист
      Кожаный Карьерист
      даже без учета цены на железо, локальная она медленная... К примеру, скорость будет 100 токенов в секунду, в час это 360 тыс. токенов. Условно, в сутки около 9 млн. токенов. Это если целые сутки машина будет работать без перерыва, чтобы наработать такое количество токенов. Но у меня один запрос к Deepseek для нового небольшого проекта отъедает 1 млн. токенов в OpenCode, стоит копейки и по времени занимает 1-2 минуты. А мощности большой модели и локальной несопоставимы. К этому добавляется амортизация железа локальной машины. Плюс расходы на электричество. В общем, получается выгоды как-то и нет, совсем... Очень нишевая тема Ответить
      раскрыть ветку (18)
      • Мудрый Маркиз
        Мудрый Маркиз
        Я понимаю, но я про будущее, сейчас нет таких технологий, пока выгоднее у компании брать Ответить
      • Невидимый Гриб
        Невидимый Гриб
        Локально нейронка нужна если политика безопасности организации требует, что бы данные не покидали внутренний контур. Ответить
        раскрыть ветку (10)
        • Шустрый Специалист
          Шустрый Специалист
          Да можно и в таких случаях анонимизировать... В чем проблема? Ответить
          раскрыть ветку (8)
          • Невидимый Гриб
            Невидимый Гриб
            Вы берете и бахаете бухгалтерскую отчетность на анализ. А корпораций размера сбера, Газпрома и пр. по пальцам посчитать. И по отдельным цифрам я вам безошибочно скажу, чья это отчётность Ответить
            раскрыть ветку (7)
            • Шустрый Специалист
              Шустрый Специалист
              Нет. Финансовые данные анонимизируются по другому... Не скажете. Ответить
              раскрыть ветку (6)
              • Невидимый Гриб
                Невидимый Гриб
                Расскажите это клерку😂 Люди ленивы и глупы. Ответить
                раскрыть ветку (3)
                • Шустрый Специалист
                  Шустрый Специалист
                  При чем здесь клерки? Это вопрос безов. Ответить
                  раскрыть ветку (2)
                  • Невидимый Гриб
                    Невидимый Гриб
                    Читали месяц назад тетеньку уволили и она судилась. Топ, какой то российской компании. В нейронку грузила все Ответить
                  • Невидимый Гриб
                    Невидимый Гриб
                    Comment media
              • Невидимый Гриб
                Невидимый Гриб
                Некоторые умники делают фото своего рабочего места, а там документы. Все это в сеть выкладывают. Очень много интересного я на этих фото видел не раз. Ответить
                раскрыть ветку (1)
                • Шустрый Специалист
                  Шустрый Специалист
                  Тоже вопрос безов... Ответить
        • Кожаный Карьерист
          Кожаный Карьерист
          это понятно, просто многие в том числе и я пытаются локальными заменить облачные. Или если по-простому хотят на..ать систему, но у них это плохо получается 😁 Ответить
      • Строганый Дирижер
        Строганый Дирижер
        Локальная модель позволяет обдумывать шаги а скорости на ответ в от 30-50 т/сек вполне достаточно . Просто цели и задачи разные у облачных и локальных . В облачных вас всех имеют а в локальных нет. Ответить
        раскрыть ветку (4)
        • Кожаный Карьерист
          Кожаный Карьерист
          в OpenCode можно обдумывать шаги, можно подключить кучу моделей, и в тоже время скорость будет в разы больше, чем у локальных Ответить
          раскрыть ветку (3)
          • Строганый Дирижер
            Строганый Дирижер
            Да не хочу 20$ тратить у меня qwen3.8-27b и в Клод коде и в опенкоде и в пи и омп и даже кило коде отлично работает бесплатно Ответить
            раскрыть ветку (2)
            • Кожаный Карьерист
              Кожаный Карьерист
              Comment media
              вот например. Интересно, сколько времени бы ушло на локальной ллм на генерацию 300 млн. токенов) Ответить
            • Зевающий Ленивец
              Зевающий Ленивец
              И сколько токенов в секунду выдает и железо какое? Ответить
      • Зевающий Ленивец
        Зевающий Ленивец
        100 токенов в секунду, эх, если 20 выдаст считай хорошо ))) Ответить
    • Раздражительный Жираф
      Раздражительный Жираф
      а мне что-то кажется локальные модели — чисто корп тема для чувствительных данных, всё остальное будет дешевле и проще юзать в облаках по потребности.

      А там где надо будет грузить корп документацию и свои внутрекорпоративные раги и пр. ебалу строить, корпораты найдут денежку на железки, чтобы поднять локальные модели Ответить
      раскрыть ветку (4)
      • Кожаный Карьерист
        Кожаный Карьерист
        а еще локальные могут быть полезны для обхода цензуры облачных) Ответить
        раскрыть ветку (3)
        • Раздражительный Жираф
          Раздражительный Жираф
          да, на порнхабе этот нейродроч уже появился, пролистываю Ответить
          раскрыть ветку (2)
          • Кожаный Карьерист
            Кожаный Карьерист
            необязательно 😁 софт тоже бывает с нюансами, да хоть тот же парсинг. Каптчу обойти, это уже незаконная деятельность Ответить
          • Автор канала
            Автор канала
            Ты там береги здоровье пожалуйста Ответить
  • Пепельный Медведь
    Пепельный Медведь
    А пруфы будут? А то написать можно всякое Ответить
    раскрыть ветку (1)
    • Бархатный Рогалик
      Бархатный Рогалик
      Нет токенов в секунду. Можно считывать каждый раз экспертов с диска, но тратить на кажую генерацию 20 лет (вот так GLM с ноутбука запускали) Ответить
  • Заляпанный Сухарь
    Заляпанный Сухарь
    1,5 токена в секунду. ну и до кучи убитый ссд ;) Ответить
    раскрыть ветку (2)
    • Лохматый Воробей
      Лохматый Воробей
      На локалке очень медленно получается да? Ответить
      раскрыть ветку (1)
      • Заляпанный Сухарь
        Заляпанный Сухарь
        это способ запуска такой. для бедных, которым очень очень надо. так то 10-20к грязных зеленых бумажек на мак студио с 512г, и квантованый до 4 бит glm 5.3 даст где то 20-30 токенов в секунду Ответить
  • Пепельный Червь
    Пепельный Червь
    Когда они все таки повысят цену токена все поймут что надо было развертывать локалку Ответить
  • Непреклонный Миротворец
    Непреклонный Миротворец
    между запустить и действительно комфортно этим пользоваться — пропасть Ответить
    раскрыть ветку (1)
    • Зевающий Ленивец
      Зевающий Ленивец
      Да даже между запустить и пользоваться, пропасть ))) Ответить
  • Циничный Бегемот
    Циничный Бегемот
    Вот - https://www.youtube.com/watch?v=IH8XmxiwliQ&t=1015s
    На RTX 3060 12 GB запустили + 64Гб ОЗУ DDR4, 24 токена, на 5070TI дает 40+ токенов/с.
    Проводили тесты сравнивая с Opus 4.8, медленнее, но не хуже.
    Тут уж будет зависеть от задач. Ответить